数据处理的完整链路 从汇聚整合到共享服务的六步闭环

在数字化时代,数据被视为新的生产要素。原始数据往往分散、杂乱、低质,只有经过一系列有序加工,才能转化为可复用、可共享的知识资产。本文梳理了一条典型的数据处理链路:形成汇聚整合、提纯加工、建模处理、算法学习,再通过连接以共享数据服务。这六个环节环环相扣,构成了从数据到价值的闭环。
第一步:汇聚整合——打破数据孤岛
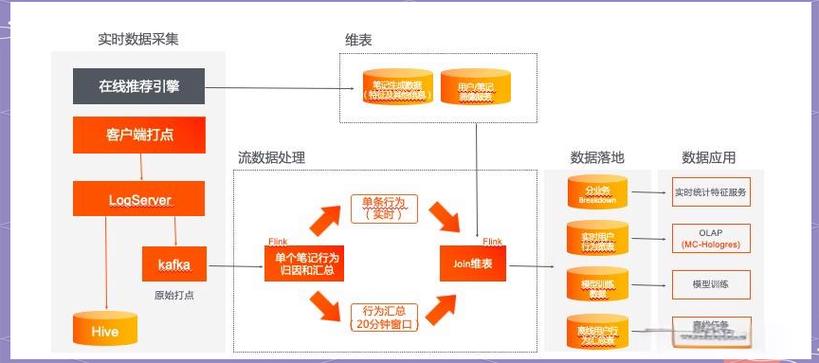
汇聚整合是数据处理的起点。企业和组织内部通常存在多个异构系统:CRM、ERP、日志文件、传感器流、外部API等。汇聚意味着通过批处理或流式采集技术,将这些来源的数据统一归集到数据湖或数据仓库中。整合则更进一步,需要解决格式差异、编码冲突和语义歧义,例如将不同部门的“客户编号”映射为全局唯一ID。此阶段的核心目标是“全”与“通”,为后续加工提供完整、一致的原料。
第二步:提纯加工——清洗、去噪与标准化
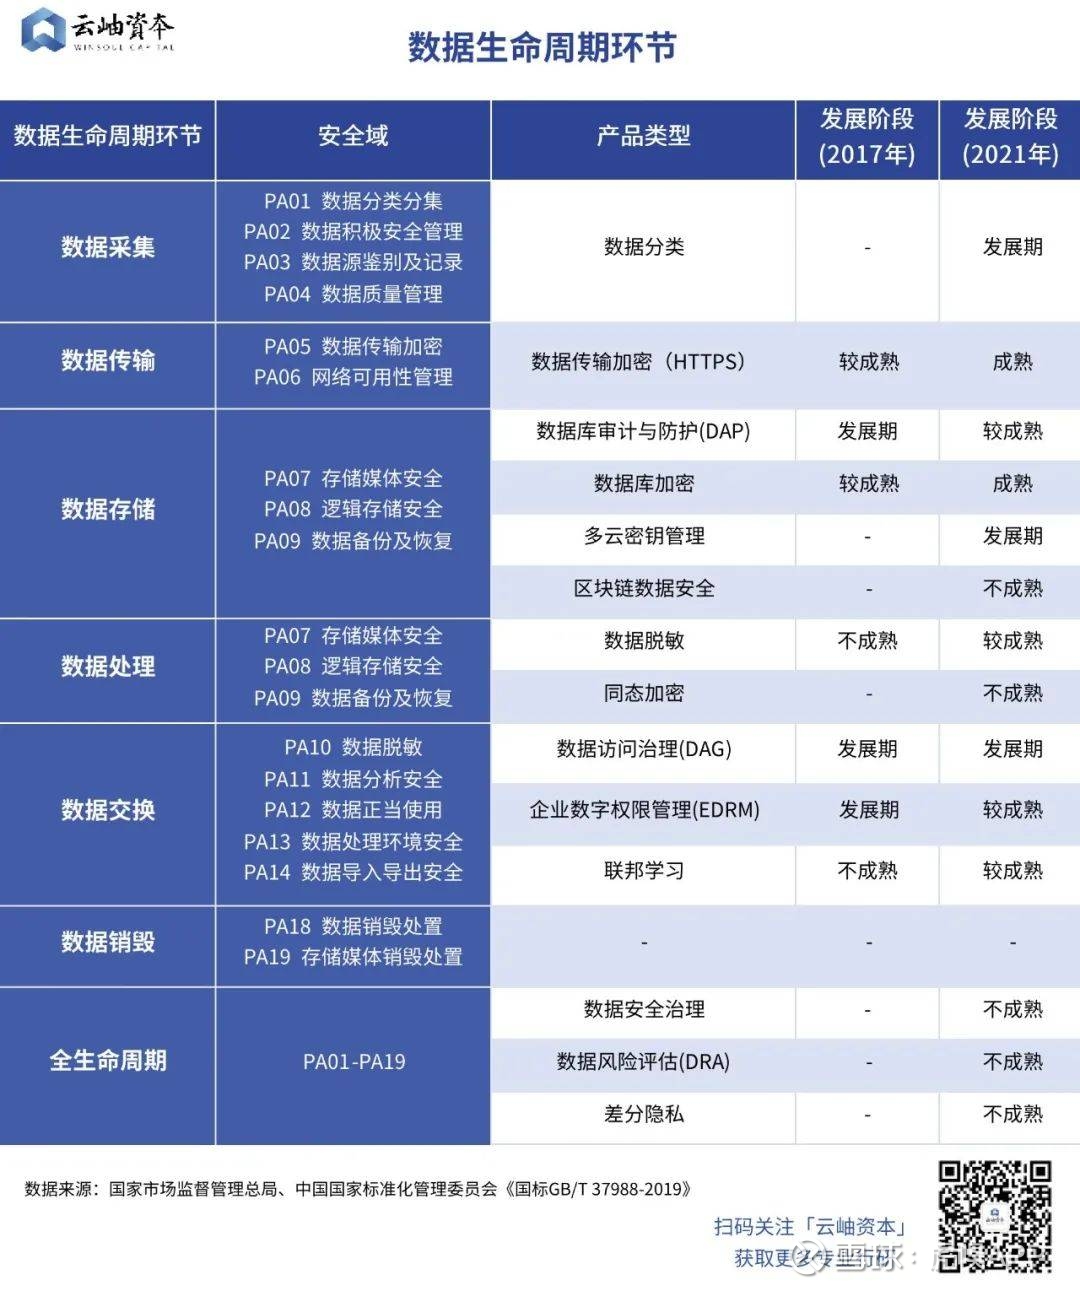
汇聚后的数据仍含有大量噪声:重复记录、缺失值、异常值、过时信息。提纯加工类似于炼油中的精炼过程。具体操作包括:去重、填充缺失、平滑异常、统一量纲、分词与标准化。例如,将“北京市”“北京”“京”统一为“北京”。还需进行一致性校验和隐私脱敏。经过提纯,数据质量显著提升,成为可信的“干净数据”。
第三步:建模处理——结构化与关联化
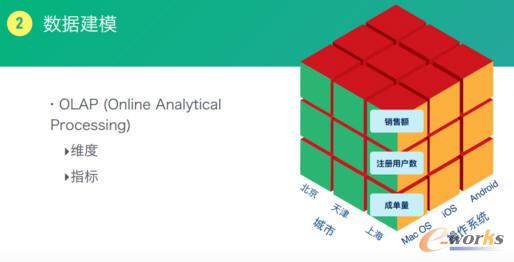
原始数据往往是扁平的,而真实世界的实体与关系是网状的。建模处理通过设计概念模型、逻辑模型和物理模型,将数据组织成易于理解和查询的结构。常见手段包括:实体-关系建模、维度建模、图建模(用于社交网络或知识图谱)。例如,将用户行为日志转化为“用户-商品-时间-行为”的四元组。建模使数据不仅可存储,还可表达业务规则和约束,为算法提供有意义的特征空间。
第四步:算法学习——从数据中提取模式
当数据具备了结构化和高质量特征后,算法学习便登场。这一步利用统计与机器学习方法,从数据中挖掘规律、预测趋势或生成洞见。典型任务包括分类、聚类、回归、推荐、异常检测等。例如,基于清洗后的交易数据训练欺诈识别模型。算法学习不是一次性活动,而是持续迭代:模型上线后需监控其表现,并通过新数据重新训练。至此,数据已从被动记录转化为主动智能。
第五步:通过连接以共享——数据服务化
模型和洞见只有被广泛使用才能产生更大价值。连接与共享意味着构建数据服务接口(API、消息队列、数据订阅),使不同团队、系统或合作伙伴能够安全、高效地获取加工后的数据或模型结果。关键机制包括:元数据管理、权限控制、服务等级协议、以及数据血缘追踪。例如,一个推荐模型通过REST API向App提供实时推荐。共享不是简单的导出,而是形成可编排、可组合的数据能力网络。
第六步:共享数据服务——闭环反哺与生态效应
我们得到的是“共享数据服务”这一产品化形态。它可以是数据资产目录中的可查询数据集,也可以是实时决策引擎。更重要的是,共享服务会反哺前五个环节:使用方反馈数据质量、调用日志成为新的汇聚来源、新数据触发重新建模与学习。这种循环使数据系统具备自进化能力。当多个组织互联时,还能形成跨域数据空间,释放网络效应。
从汇聚整合到共享服务,数据处理是一个提纯、结构化、智能化、服务化的连续过程。每个环节都有其独特的技术与治理要求,而“连接”贯穿始终——连接数据源、连接模型、连接人与系统。只有打通这条链路,数据才能从沉默的字节,变成流动的决策与创新动力。
最新产品